Я не называю SaaS готовым к росту, пока один клиент может замедлить остальных
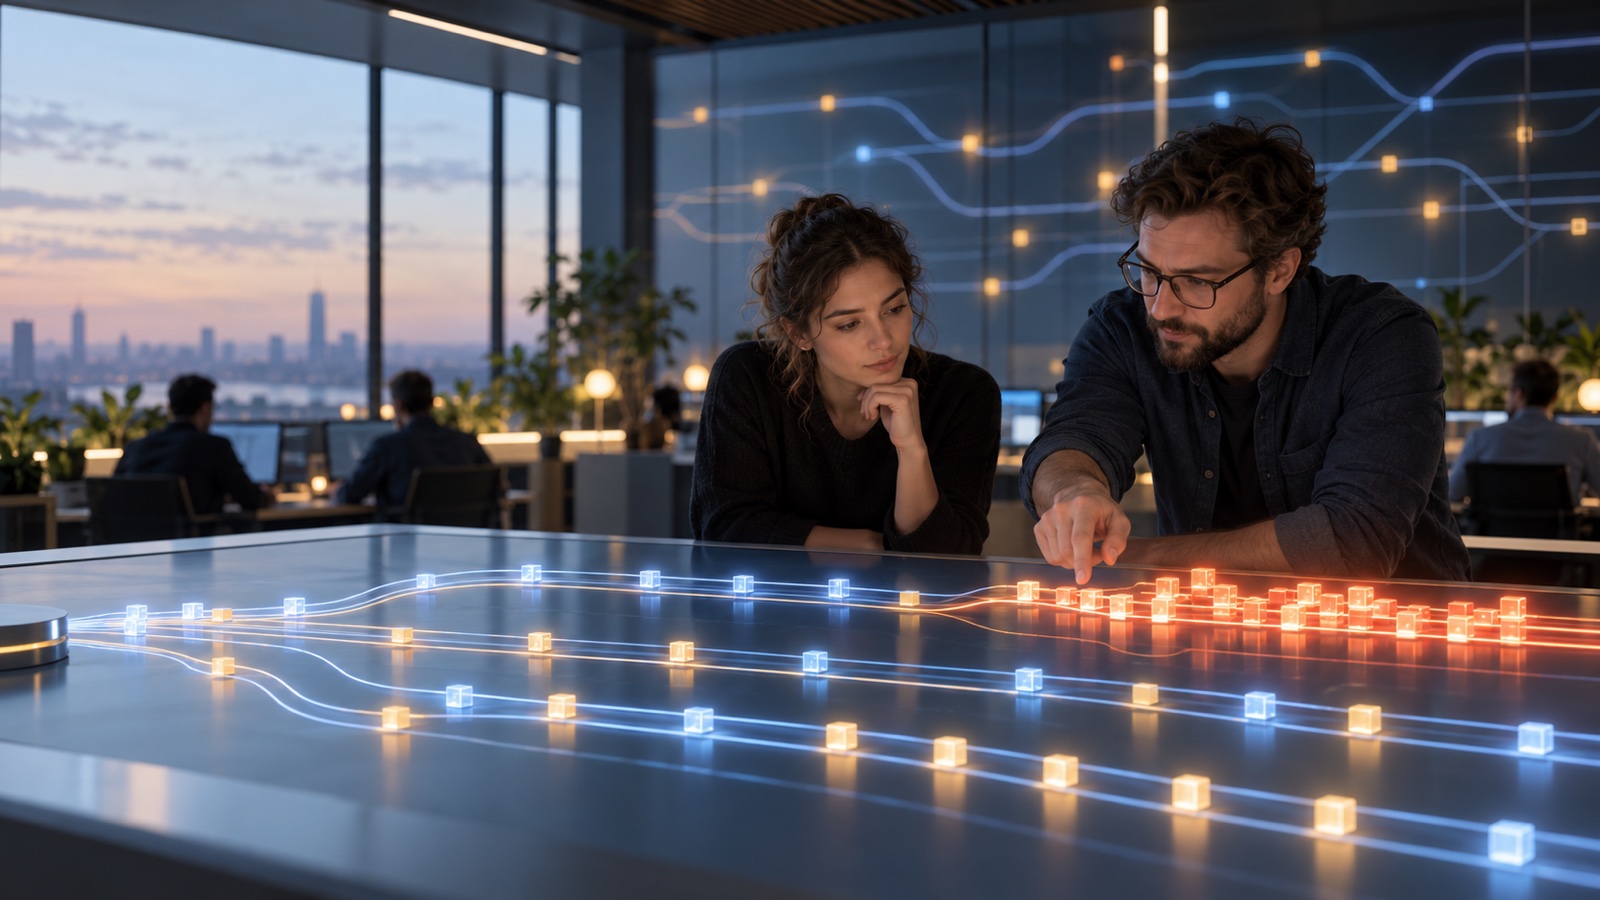
Я не называю SaaS готовым к росту, пока один активный клиент может незаметно замедлить остальных. В начале у сервиса почти всегда есть запас: задач мало, команда рядом, а редкая задержка выглядит случайностью. Потом один импорт, тяжёлый отчёт или серия повторных запросов занимает общий ресурс — и обычные пользователи ждут вместе с ним.
Проблема здесь не в самом крупном клиенте. Крупный клиент как раз может быть самым ценным и самым разумным. Проблема в устройстве общего прохода: если все входят в одну дверь, тот, кто несёт большой груз, невольно задерживает остальных.
Рост начинается с границ, а не с ещё одного сервера
Первой реакцией часто становится покупка мощности. Она бывает нужна, но сама по себе не отвечает на главный вопрос: что именно делят между собой клиенты? Общей может оказаться очередь фоновых задач, соединение с внешним сервисом, база данных, расчёт отчёта, файловое хранилище или ограничение партнёрского API.
Если не назвать этот ресурс, дополнительный сервер иногда лишь быстрее довезёт перегрузку до следующего узкого места. Это похоже на расширение дороги перед единственным мостом: машин на трассе станет больше, а очередь у моста останется.
Я начинаю с простого рисунка рабочего дня. Один клиент утром загружает большой каталог. Другой в это же время должен подтвердить несколько заказов. Третий ждёт уведомление о платеже. Какая из этих операций может подождать минуту, а какая не должна зависеть от чужой загрузки? Такой разговор полезнее абстрактного обещания «выдержать нагрузку».
Ранее я уже разбирал, почему нагрузочный сценарий стоит описывать языком рабочего дня, а не только числом запросов в секунду. Здесь важны роли, действия и ожидание человека. Для SaaS к ним добавляется ещё один вопрос: чья работа не должна пострадать от чужого пика?
У каждого общего ресурса должна быть честная очередь
Очередь сама по себе не делает систему справедливой. Если все задания попадают в неё в том порядке, в каком пришли, длинная пачка одного клиента легко займёт всё место. Снаружи это выглядит странно: небольшая команда нажала одну кнопку и ждёт, хотя у неё совсем другая задача.
Поэтому мне важнее не «есть ли очередь», а как она делит право на следующий шаг. Иногда достаточно ограничить число одновременно выполняемых тяжёлых задач на одного клиента. Иногда нужны отдельные очереди для срочных действий и для долгих расчётов. Иногда разумно выдавать каждому клиенту небольшую долю времени по кругу, а не позволять одному запросу съесть всё сразу.
Это не наказание активного клиента. Наоборот, понятное правило защищает всех, включая его самого. Когда сервис честно показывает, что массовая операция выполняется в фоне и не остановит текущую работу команды, клиент может планировать процесс. Хуже всего скрытая лотерея: сегодня импорт прошёл быстро, завтра та же операция блокирует заказы, а объяснить причину никто не может.
Приоритет — это обещание, а не цветная метка
Второй соблазн — назвать всё важное срочным. Через пару месяцев «срочной» становится почти каждая задача, а очередь снова превращается в одну. Я стараюсь привязывать приоритет к последствиям для работы: подтверждение платежа, действие пользователя в уже открытом окне, срок по обязательству перед клиентом, фоновая загрузка, ночной расчёт.
Для каждой группы полезно заранее договориться о трёх вещах: как долго она может ждать, сколько ресурсов может занять за один подход и что система сделает при росте очереди. Это уже не техническая мелочь. Это понятное продуктовое обещание: заказ не будет стоять из-за чужого отчёта, а длинная операция не исчезнет молча.
Не стоит путать такой приоритет с привилегией отдельного клиента. Постоянное ручное «пропустите этих вперёд» быстро разрушает модель. Гораздо здоровее разделять типы работы и заранее описывать условия, одинаковые для всех клиентов данного тарифа или сценария.
Лимит должен предупреждать, а не ловить
Лимиты часто вспоминают только тогда, когда уже случилась перегрузка. Тогда они выглядят как запрет: вчера действие работало, сегодня пользователь получил ошибку. Мне ближе другой подход: лимит — это раннее предупреждение и выбор.
Если клиент близок к объёму, который может начать мешать общей системе, полезно показать это до стоп-сигнала. Предложить запустить обработку ночью, разбить файл, выбрать фоновой режим или подключить подходящий уровень сервиса. Важно, чтобы человек понимал, что происходит с его данными и когда работа закончится.
Особенно опасны лимиты без обратной связи. Система принимает загрузку, а потом часами ничего не говорит. Пользователь нажимает кнопку ещё раз, появляются дубли, оператор начинает разбираться вручную. Поэтому у ограниченного действия должны быть статус, идентификатор результата и понятный путь отменить или безопасно повторить его.
Изоляция — это не только про скорость
Один клиент может повлиять на другого не только нагрузкой. Ошибка в правилах доступа, слишком широкий поиск, неудачная миграция или общий кеш тоже способны затронуть соседей. Поэтому я смотрю на изоляцию шире: данные, фоновые задачи, доступы, лимиты и наблюдение должны позволять понять, чей именно сценарий сейчас происходит.
Это помогает и в развитии продукта. Если новая возможность требует особого правила для одного сегмента, сначала стоит отделить общее правило от настройки и разовой доработки. Так SaaS сохраняет понятность при выходе в новый сегмент, а не превращается в набор исключений, который никто не решается менять.
Что я проверяю перед тем, как считать рост безопасным
Я бы прошёл пять практических вопросов. Может ли один клиент занять всю очередь или все соединения? Видит ли команда разницу между общим замедлением и проблемой одного клиента? Есть ли для тяжёлой операции честный статус, отмена и безопасный повтор? Известно ли, какие действия действительно срочные для бизнеса? И можно ли временно ограничить один поток так, чтобы остальные продолжили работу?
Ответы не обязаны быть сложной схемой из десятков сервисов. Для небольшого продукта иногда достаточно одного ограничения конкурентности и отдельной очереди для тяжёлых задач. Важнее другое: правило должно быть явным, проверяемым и понятным тем, кто отвечает за продукт и поддержку.
Наблюдение должно показывать не только среднюю температуру
Среднее время ответа легко успокаивает. Если девять клиентов получили результат за секунду, а десятый ждал десять минут, среднее значение может выглядеть вполне прилично. Но именно десятый клиент напишет в поддержку и перестанет доверять сервису. Поэтому я смотрю на ожидание по типу работы и по клиенту, а не только на общий красивый график.
Полезно видеть длину очереди, возраст самого старого задания, число повторов и долю задач, которые завершились с ошибкой или были отменены. Ещё полезнее связать эти признаки с реальным объектом: заказом, выгрузкой, расчётом, обновлением справочника. Тогда команда не просто знает, что «фон тормозит», а понимает, какая работа и у кого сейчас стоит.
Такое наблюдение не должно превращаться в круглосуточное слежение за каждым сотрудником клиента. Его задача — защитить сервис и его пользователей. Метрики нужны для решения об очереди, ограничении и мощности, а не для поиска виноватого в каждом долгом файле.
Как вводить защиту без внезапного удара по пользователям
Самая неприятная версия изменений — поставить ограничение в пятницу вечером и узнать в понедельник, что привычная операция перестала проходить. Я бы начинал с измерения: какие задачи действительно самые тяжёлые, как часто они запускаются и кому важны. Затем можно включить мягкое предупреждение, показать новый статус и проверить сценарий на небольшой группе.
После этого правило стоит испытать в условиях, близких к обычному пику. Не обязательно искусственно создавать огромную нагрузку в боевой среде. Достаточно убедиться, что срочное действие не ждёт за длинным фоновым заданием, отмена освобождает ресурс, а повторный запуск не создаёт вторую работу. Только после такой проверки ограничение становится частью продукта, а не техническим сюрпризом.
Отдельно я бы продумал разговор с поддержкой. У неё должен быть ответ не в стиле «попробуйте позже», а с понятной причиной, текущим состоянием и разрешённым действием: дождаться, отменить, разбить данные, выбрать другой момент или передать случай в техническую команду. Хорошая граница в системе всегда сопровождается хорошим объяснением человеку.
Граница должна переживать сбой
У ограничения есть ещё одно свойство, о котором легко забыть: оно должно вести себя предсказуемо при повторе, перезапуске и частичном сбое. Если работник нажал «загрузить» второй раз после долгого ожидания, система не должна начать две одинаковые операции. Если сервер перезапустился в середине задачи, следующий исполнитель не должен забрать её одновременно с прежним.
Здесь важны небольшие, но практичные детали: уникальный ключ операции, понятный срок жизни блокировки, запись о попытке и безопасная возможность возобновить работу. Они не видны в рекламном описании продукта, но именно на них держится спокойный опыт клиента в напряжённый момент.
Мне нравится проверять такой сценарий на обычном языке: «клиент загрузил большой файл, закрыл ноутбук, сеть пропала, через час он вернулся». Что увидит человек? Сможет ли он понять, завершилась работа, остановилась или ждёт? Сможет ли коллега продолжить её без звонка в поддержку? Ответ на эти вопросы часто важнее ещё одной функции в панели администратора.
Рост SaaS — не соревнование в количестве серверов. Это способность спокойно принять нового активного клиента, не заставляя остальных расплачиваться ожиданием. Когда общий ресурс разделён честно, сервис становится взрослее не на слайде, а в обычный рабочий вторник.
Обсудим?