Я ищу не виноватого в сбое, а момент, когда система перестала быть видимой
Когда бизнес-система даёт сбой, первый вопрос часто звучит так: «кто всё сломал?» Я предпочитаю другой: «в какой момент мы перестали видеть, что происходит?» Виноватого иногда найти нужно. Но пока команда собирает обрывки из чатов, скриншотов и памяти сотрудников, работа стоит независимо от фамилии.
Наблюдаемость — это не большой экран с графиками ради красивой серверной. Это способность быстро ответить на обычные вопросы: где сейчас заказ, дошла ли информация до следующей системы, кто изменил важное правило, какая очередь растёт и что почувствовал клиент.
Я стараюсь думать об этом до серьёзного сбоя. Не потому, что можно избежать всех проблем. А потому, что спокойное восстановление почти всегда дешевле героического расследования, когда одновременно звонят клиенты, бухгалтерия и менеджеры.
Система становится непрозрачной постепенно
Обычно никто не решает специально сделать систему непонятной. Сначала появляется один обмен с CRM. Потом к нему добавляют учётную систему, уведомления, файл с выгрузкой и отдельный кабинет подрядчика. Каждый кусок по отдельности работает. Но через несколько изменений уже трудно сказать, где находится источник правды и какой шаг считается успешным.
В нормальный день это незаметно. Проблема проявляется, когда клиент сообщает: «заявку отправили, а ответа нет». Продажи видят запись у себя. Исполнение не видит её в очереди. Разработчик говорит, что обмен прошёл. И все одновременно правы, потому что смотрят на разные фрагменты маршрута.
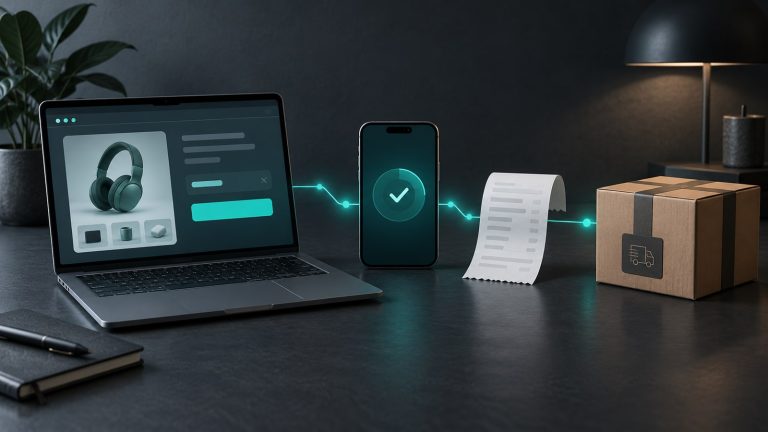
Это похоже на доставку посылки без трек-номера. Можно позвонить каждому участнику цепочки, но быстрее и спокойнее видеть, когда посылку приняли, куда передали и где она остановилась. В IT-системе такая видимость нужна не только инженерам. Она нужна руководителю процесса.
Я начинаю с вопросов бизнеса
Первый соблазн — сразу выбрать инструмент мониторинга. Но инструмент не ответит, что именно важно заметить. Сначала я собираю несколько ситуаций, которые для бизнеса действительно неприятны: заказ не попал в исполнение, счёт не обновился после оплаты, сотрудник получил не тот доступ, отчёт показывает устаревшие цифры.
Для каждой ситуации полезно договориться о четырёх точках. Что считается началом? Как выглядит успешный результат? Какой сигнал говорит, что работа застряла? Кто принимает решение, когда сигнал появился? Это уже не разговор о технологии, а понятная карта ответственности.
Например, недостаточно сказать: «интеграция работает». Нужно определить: заказ создан, ему присвоен понятный идентификатор, исполнитель получил нужные данные, а если передача не состоялась, очередь видна определённой роли. Тогда команда может проверить маршрут без поисков по всем логам.
Не все сигналы одинаково полезны
Если уведомлений слишком много, их перестают читать. Я не верю в контроль каждой мелочи. Полезнее выбрать несколько событий, после которых нужно действие. Например, поток заказов остановился, растёт число неуспешных обменов, важная очередь не сокращается, меняются права критичной роли или резервная копия не прошла проверку.
У каждого сигнала нужен владелец и понятный первый шаг. Иначе уведомление только создаёт тревогу. Фраза «ошибка API» мало помогает собственнику и может не помочь дежурному специалисту. Гораздо полезнее: «заказы не передаются в исполнение; проверьте очередь обмена и последние три неуспешные операции».
Так система учится говорить человеческим языком: не «что-то техническое случилось», а «вот какой рабочий маршрут оказался под угрозой». Это упрощает разговор между бизнесом и IT и помогает не путать заметную техническую мелочь с реальной проблемой клиента.
Журнал изменений нужен не только разработчикам
Ещё одна часть прозрачности — история важных изменений. Когда изменили правило расчёта, маршрут согласования, права доступа или обработку обмена, через месяц трудно восстановить контекст по памяти. Короткая запись с датой, причиной, владельцем и ожидаемым эффектом экономит много времени во время разбора.
Это не требование вести дневник каждой правки. Я бы фиксировал только изменения, которые способны повлиять на реальную работу клиента, деньги, доступы или отчёты. У такой записи есть практическая ценность: если после релиза что-то изменилось, команда может сопоставить событие с принятым решением, а не строить догадки.
Важно, чтобы журнал был доступен не одному инженеру. Руководитель процесса должен понимать, что изменилось в его маршруте и к кому идти с вопросом. Тогда техническая часть не прячется за непрозрачной стеной, а становится управляемой частью бизнеса.
Разделяйте контроль и вмешательство
Наблюдаемость не означает, что руководитель должен следить за каждым действием сотрудника. Цель не в микроменеджменте, а в раннем обнаружении ситуаций, где процесс перестал давать обещанный результат. Хорошая система показывает очередь, задержку или ошибку маршрута, но оставляет людям пространство для нормальной работы.
Например, менеджеру не нужен сигнал о каждом новом заказе. А вот очередь заказов без назначения дольше согласованного времени — это уже повод проверить, хватает ли данных, роли или людей. Такой сигнал говорит не «кто плохо работает», а «где владельцу процесса нужно принять решение».
Это особенно ценно, когда компания растёт. Пока все сидят рядом, неудобный момент заметят по голосу коллеги. Когда команд и систем становится больше, нужен общий способ увидеть проблему без постоянных созвонов. Иначе организация продолжает управляться личной памятью, только дороже.
Путь одного объекта лучше общей схемы
Для первой проверки я выбираю один объект: заказ, заявку, счёт или обращение. У него должен быть идентификатор, который проходит через все важные этапы. Тогда можно взять конкретный случай и увидеть его путь без догадок.
Это особенно важно там, где системы обмениваются данными. Общая надпись «обмен успешен» может скрывать частичные ошибки: часть записей передана, часть ушла без деталей, часть ждёт ручного подтверждения. А конкретный маршрут показывает, какую информацию видел каждый участник и где появилось расхождение.
Границы интеграции — не техническая деталь. Это договорённость, какая система за что отвечает и как она сообщает об ошибке. В материале о границах интеграции я разбираю, почему полезно определить эти обязательства до того, как связей станет слишком много.
Отчёт без владельца тоже плохо наблюдаем
Иногда руководитель видит красивую витрину показателей, но не знает, когда им можно доверять и кто должен реагировать на отклонение. Это не наблюдаемость, а картинка. У каждого важного числа должна быть понятная дата обновления, источник и человек или роль, которые разбирают проблему.
Например, снижение числа оформленных заказов может быть реальным изменением спроса, а может означать, что перестала приходить часть заявок. Без связи показателя с рабочим маршрутом команда спорит о выводах вместо того, чтобы проверить входные данные.
Это продолжение мысли из статьи о показателе без владельца: число становится полезным только тогда, когда ясно, кто и какое решение принимает на его основе.
Проверяйте восстановление, а не только фиксацию ошибки
После сбоя команда часто радуется, когда ошибка исчезла с экрана. Но пользователю важнее другое: вернулся ли маршрут в нормальное состояние, обработаны ли зависшие объекты, не появились ли дубликаты и знает ли владелец процесса, что делать с последствиями.
Я бы зафиксировал короткий порядок: как обнаруживаем проблему, где смотрим путь объекта, кто принимает решение об остановке или повторной отправке, как подтверждаем восстановление и что сохраняем для следующего разбора. Не нужен тяжёлый регламент на десятки страниц. Нужна инструкция, которой можно воспользоваться в напряжённый момент.
Здесь наблюдаемость связана с архитектурой. Архитектурное решение — это не только выбор технологии, но и цена будущего изменения или ошибки. Если при любой неполадке нужно собирать пять человек, открывать три кабинета и вручную сопоставлять данные, стоимость владения системой уже растёт. Об этом шире говорю в статье «Архитектура — это цена будущих изменений».
С чего начать без большой программы
- Выберите один маршрут, сбой которого заметит клиент или руководитель.
- Опишите его начало, успешный конец и владельца каждого важного перехода.
- Дайте объекту идентификатор, который видно во всех связанных системах.
- Настройте один понятный сигнал для остановки или роста очереди.
- Один раз пройдите восстановление на реальной безопасной ситуации и поправьте инструкцию.
После этого можно добавлять детали: метрики, журнал изменений, уровни уведомлений, автоматическую проверку обменов. Но основа уже будет правильной: бизнес видит свой процесс, а техническая команда понимает, какой результат надо защитить.
Что стоит обсудить на следующем разборе
После любого заметного сбоя полезно выделить короткое спокойное время не для поиска виноватых, а для улучшения маршрута. Где мы увидели проблему впервые? Какая информация оказалась недоступной? Какое решение пришлось принимать на ощупь? И какой один сигнал или след сократит этот путь в следующий раз?
Ответы лучше превращать в небольшие действия с владельцем и датой проверки. Один понятный идентификатор, одно исправленное сообщение об ошибке или одна видимая очередь часто полезнее большого списка пожеланий. Так разбор сбоя постепенно создаёт более надёжную систему, а не остаётся документом, который никто не открывает.
Если решение касается сразу нескольких команд, важно договориться о владельце архитектурного выбора. Иначе каждая сторона улучшит свой участок, а общая граница останется ничьей. Эту проблему я отдельно разбирал в статье о выборе без владельца: спор заканчивается не тогда, когда громче аргумент, а когда у решения появляются критерии и ответственность.
Наблюдаемость надо включать в стоимость решения
При выборе новой системы или интеграции обычно обсуждают срок запуска и цену реализации. Я бы добавлял ещё один вопрос: как мы будем понимать, что это работает через полгода, когда автор первоначальной схемы занят другим проектом? Если на него нет простого ответа, в оценке не хватает важной части работы.
Это не обязательно дорогая платформа. Иногда достаточно согласованных статусов, сохранённого идентификатора, понятного журнала и пары проверок. Но эти вещи нужно предусмотреть до запуска, а не собирать ночью после первой серьёзной проблемы. Тогда стоимость владения становится видна заранее, а не появляется неприятной строкой после подписанного акта.
Для собственника это практический критерий качества: система должна не только выполнять действие, но и позволять проверить его результат без героизма. Чем меньше зависимость от памяти отдельных людей, тем устойчивее бизнес в обычный день и в момент сбоя.
Я не рассчитываю, что хорошая наблюдаемость отменит ошибки. Она делает другое: возвращает команде время и ясность в момент, когда они особенно нужны. Вместо поиска единственного виноватого появляется общий путь к ответу — где остановилась работа, кто может принять следующее решение и как убедиться, что клиент снова получил ожидаемый результат.
Обсудим?