Я не называю интеграцию надёжной, пока не могу проследить одну операцию целиком
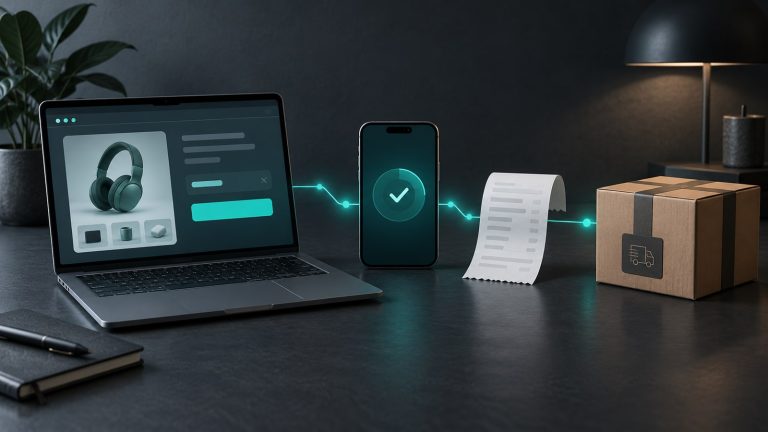
Интеграция выглядит надёжной, пока на демонстрации заказ появляется в двух системах. Я начинаю доверять ей позже — когда могу взять одну конкретную операцию и проследить её путь целиком: от действия человека до результата в другой системе. Где она принята, где преобразована, что ответила следующая сторона, кто увидит ошибку и можно ли безопасно повторить попытку.
Это не стремление обложить процесс техническими терминами. Для бизнеса один потерянный заказ или дважды созданный платёж важнее красивой схемы сервисов. Если команда не может объяснить историю конкретной операции за несколько минут, она узнает о проблеме слишком поздно — из звонка клиента, отчёта бухгалтера или склада.
Почему общего статуса «обмен работает» недостаточно
Во многих проектах есть индикатор: обмен включён, последняя синхронизация прошла успешно. Он полезен, но отвечает только на общий вопрос. Он не скажет, почему заказ № конкретного клиента не появился в учётной системе, почему его статус вернулся старым или почему после повтора создалось два документа.
Система может честно сообщать «успешно», потому что отправила пакет в очередь. А следующая система отвергла его через минуту из-за пустого поля. Или приняла запись, но не смогла применить один из товаров. Снаружи всё похоже на тишину; внутри уже началась ручная работа, которую никто не планировал.
Поэтому я стараюсь смотреть не на обмен как на чёрную трубу, а на путь операции. У этого пути должен быть идентификатор, который проходит вместе с данными или хотя бы связывает записи в журналах. Тогда вопрос «что с этим заказом?» превращается из расследования по переписке в обычную проверку.
Возьмите один сценарий, который важен бизнесу
Не надо начинать с десятков типов сообщений. Выберите один сценарий, остановка которого заметна: создание заказа, передача оплаты, обновление остатков, выпуск документа. Пройдите его как пользователь и запишите точки пути.
- Где операция рождается и кто её запускает.
- Какие правила проверяются до отправки.
- В какую очередь, API или файл она попадает.
- Как получатель подтверждает приём.
- Как исходная система узнаёт итог и показывает его человеку.
Такая карта обычно короче архитектурной диаграммы, но полезнее в первый день сбоя. Она помогает увидеть, что «интеграция CRM и учёта» на деле состоит из нескольких независимых решений: проверка данных, отправка, повтор, сопоставление ответа, уведомление владельца.
Ошибка должна сохранять контекст
Сообщение «ошибка 500» редко помогает человеку, который отвечает за заказ. Полезная ошибка говорит: какая операция не прошла, на каком шаге, что уже произошло и какое действие безопасно дальше. Например: «Заказ отправлен в учётную систему, ответ не получен за пять минут; повтор пока не запускать, проверьте статус по идентификатору». Это совсем другой уровень управляемости.
Для этого не нужно показывать менеджеру технический журнал. Достаточно связать технический след с рабочим объектом: заказом, договором, заявкой. А разработчикам оставить детали: время, ответ, версию данных, количество попыток. Между этими двумя слоями не должно быть пропасти.
В статье «Я ищу не виноватого в сбое, а момент, когда система перестала быть видимой» я разбирал ту же мысль шире: полезно видеть не только факт аварии, но и момент, когда команда потеряла способность понять происходящее.
Повторная отправка — часть сценария, а не аварийная кнопка
Сети обрываются, внешние системы отвечают медленно, люди дважды нажимают кнопку. Это обычная реальность, а не редкое исключение. Поэтому вопрос не в том, случится ли повтор, а в том, что он сделает с данными.
Надёжный сценарий умеет отличать новую операцию от повторной. Он не создаёт второй счёт только потому, что первый ответ потерялся по дороге. Если автоматический повтор опасен, система должна ясно остановиться и показать человеку причину. О том, почему интеграцию нельзя считать готовой до проверки повторной отправки, есть отдельный разбор: «Я не считаю интеграцию готовой, пока она не пережила повторную отправку».
Граница ответственности важнее количества связей
Иногда проблему пытаются решить ещё одной прямой связью между системами. Но чем больше таких связей, тем труднее понять, где живёт правило. Одна система считает заказ отменённым, другая — отгруженным, третья ещё ждёт подтверждения. Добавить новый обмен легко; договориться о смысле статусов сложнее, но именно это даёт устойчивость.
Перед интеграцией полезно назвать владельца каждого правила: кто определяет статус, кто хранит сумму, кто решает, что делать с отменой. Это не означает, что одна система должна стать главной во всём. У разных фактов могут быть разные источники. Важно, чтобы границы были видны. Об этом подробнее — в статье о границах интеграции между системами.
Журнал нужен не для поиска виноватого
Когда операция прошла через несколько систем, люди легко начинают искать того, кто «сломал интеграцию». Это почти всегда уводит разговор в сторону. Полезнее восстановить последовательность: какие данные были на входе, какое правило применилось, что отправили, что получили в ответ и какое действие сделала система после ответа. Журнал превращает догадки в проверяемые факты.
При этом журнал не должен быть складом всего подряд. Для бизнес-операции достаточно хранить связующий идентификатор, время ключевых шагов, результат, причину отклонения и версию важного правила. Технические детали могут лежать глубже. Главное, чтобы между ними можно было перейти без ручного поиска по пяти системам.
Это полезно и после успешного запуска. Когда команда меняет формат данных или правило обработки, она может сравнить несколько операций до и после изменения. Если путь стал длиннее, выросло число повторов или появились новые исключения, проблему видно раньше, чем она попадёт в ежемесячный отчёт. Поэтому журнал изменений — не формальность; это способ сохранить контекст изменений, когда систему продолжают развивать.
Понятный сигнал для владельца процесса
Техническая команда может знать о сбое по мониторингу, но владельцу процесса нужен другой сигнал: что именно перестало получаться у бизнеса и какой у этого приоритет. Сообщение «очередь недоступна» важно инженеру. Руководителю продаж важнее «новые заказы не передаются в учёт; клиенты пока не увидят подтверждение; следующий пересмотр через десять минут».
Я бы заранее договорился о трёх уровнях. Первый — обычная задержка, которую система сама догонит. Второй — исключение, которое должен разобрать назначенный сотрудник. Третий — остановка значимого процесса, когда нужны понятное решение и информирование людей. Тогда интеграция не живёт отдельно от бизнеса, а её надёжность измеряется способностью команды спокойно пройти неидеальный день.
Минимальная проверка надёжности
Перед запуском я бы попросил команду показать пять вещей на одном тестовом примере:
- где виден идентификатор операции;
- какой путь она прошла и сколько занял каждый шаг;
- как выглядит понятная бизнесу ошибка;
- что произойдёт при повторной отправке;
- кто принимает решение, если операция зависла.
Если на любой вопрос приходится отвечать «надо спросить у разработчика», интеграция ещё не стала частью управляемой системы. Это не обвинение команде. Это сигнал добавить наблюдаемость и договориться о рабочем процессе до того, как через неё пойдут деньги, обязательства и клиенты.
Самая полезная привычка здесь проста: время от времени берите случайную операцию и проходите её путь без подготовки. Как пожарная тренировка показывает, открывается ли запасной выход, так эта проверка показывает, сможете ли вы реально управлять связью между системами, когда что-то пойдёт не по плану.
Обсудим?