Я проверяю наблюдаемость системы по пути одной критичной операции
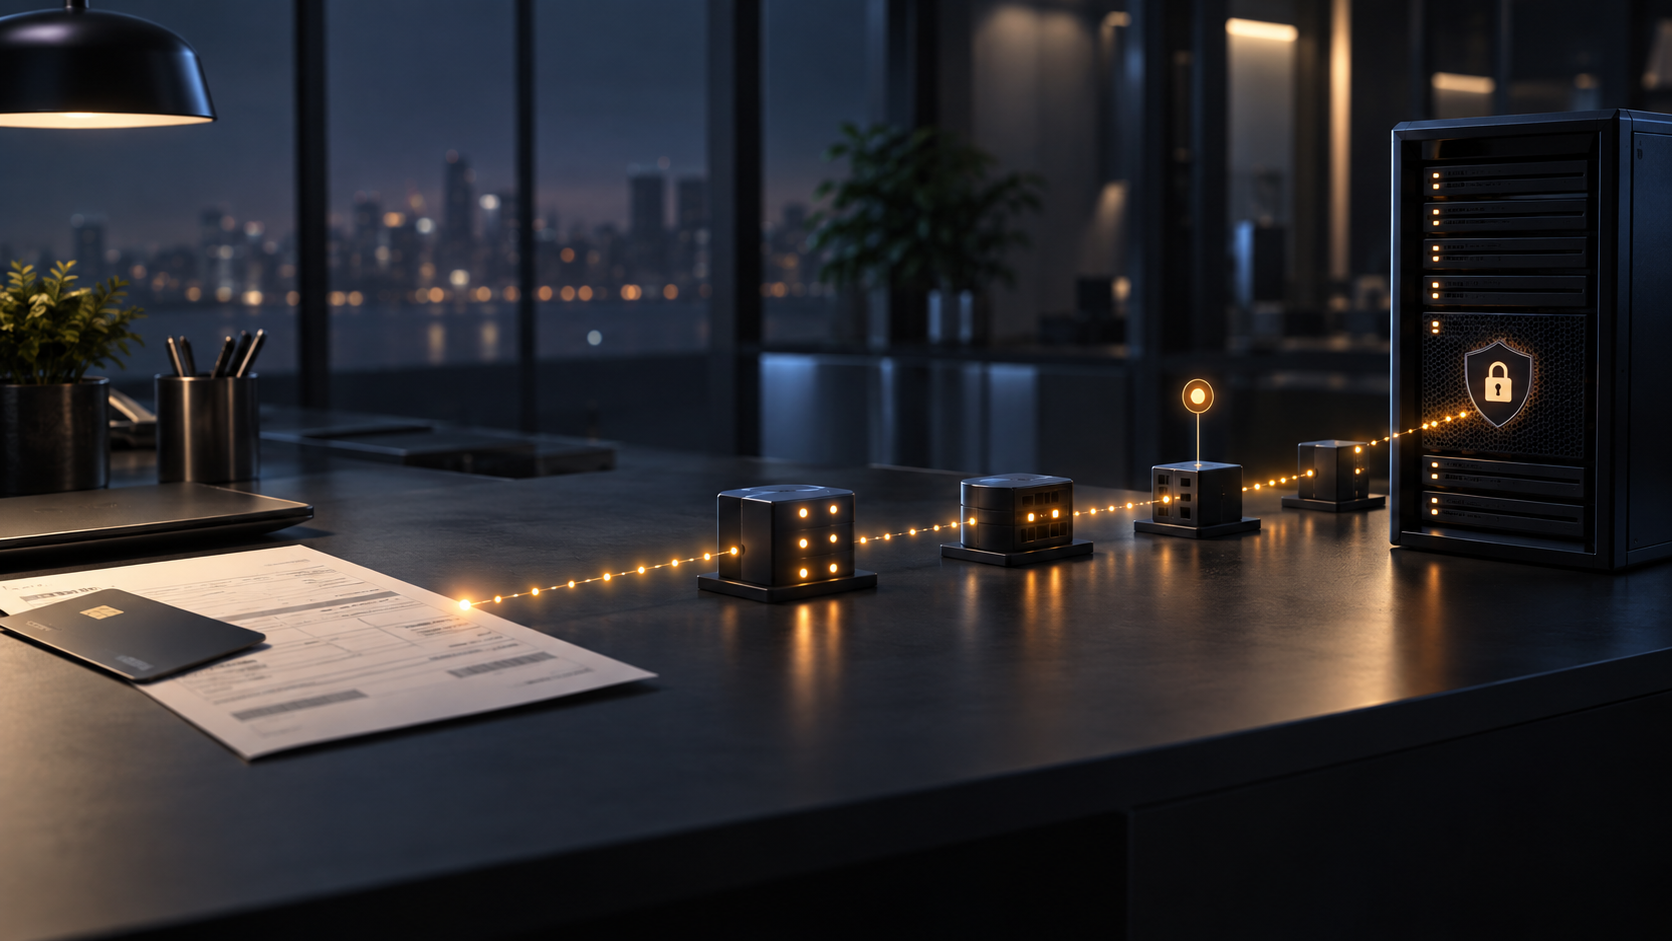
Я не называю систему управляемой, пока по одной важной операции нельзя понять, где она сейчас находится и что с ней происходило. Красивый дашборд с общими графиками здесь не спасает. Когда завис платёж, потерялся заказ или не ушёл документ, бизнесу нужен путь конкретной операции, а не средняя температура за сутки.
Наблюдаемость часто вспоминают после сбоя. В этот момент команда открывает логи, пишет друг другу названия сервисов и пытается восстановить историю по кусочкам. Это похоже на поиск посылки без трек-номера: все уверены, что она где-то была, но никто не может сказать, в какой момент и у кого она исчезла.
Начать стоит с операции, а не с инструмента
Можно долго выбирать систему мониторинга, собирать метрики и настраивать оповещения. Но полезнее сначала назвать несколько операций, остановка которых заметна бизнесу. Не «работает API», а «деньги по заказу подтверждены и заказ можно передать в исполнение». Не «очередь жива», а «документ дошёл до учётной системы и получил номер».
Для каждой такой операции я бы описал простой путь: где она возникает, какие системы трогает, где меняет состояние, какие ошибки допустимы и что считается финальным успехом. В этой схеме быстро видно, что именно нужно наблюдать.
Важно не пытаться охватить всё. Если команда не может проследить хотя бы три самых критичных пути, сотня второстепенных графиков создаст скорее чувство контроля, чем контроль.
Один идентификатор связывает историю
Самая практичная основа — единый идентификатор операции. Он рождается в начале пути и проходит через все значимые шаги: веб-сайт, внутреннюю систему, очередь, интеграцию, уведомление. Тогда любой участник может открыть одну карточку или поиск и увидеть не набор отдельных событий, а цельную историю.
Это не обязательно означает сложную платформу. В небольшом продукте достаточно договориться, какой номер передаётся дальше и где он сохраняется. В более сложной архитектуре нужны корреляционные идентификаторы и единый формат журналов. Принцип остаётся тем же: сигнал без связи с конкретной операцией мало помогает принять решение.
Похожий подход нужен и для интеграций. Я уже разбирал, почему нельзя считать интеграцию надёжной, пока нельзя проследить одну операцию целиком. Повторная отправка, задержка или чужая ошибка становятся понятнее, когда видно, что произошло именно с этим заказом, а не с абстрактным запросом.
Четыре вопроса к каждой критичной точке
Для одного шага операции я обычно хочу видеть ответ на четыре простых вопроса:
- Пришла ли операция сюда? Иначе непонятно, искать проблему до этого шага или внутри него.
- Что система попыталась сделать? Например, отправить документ, забронировать товар, провести оплату.
- Чем попытка закончилась? Успех, ожидаемая остановка, временная ошибка или неизвестный результат — это разные состояния.
- Что делать дальше? Повторить безопасно, ждать, передать человеку или отменить действие.
Последний вопрос часто забывают. Лог может объяснить разработчику причину ошибки, но руководителю процесса нужен следующий шаг. Если после уведомления всё равно требуется искать человека, который знает систему наизусть, наблюдаемость ещё не стала рабочим инструментом.
Метрики нужны для картины, события — для расследования
Метрика отвечает на вопрос «что происходит с системой в целом». Например, выросла ли доля ошибок, как долго обрабатываются операции, сколько сообщений ждёт в очереди. Это хороший ранний сигнал.
Событие отвечает на другой вопрос: «что случилось с конкретной операцией». Оно хранит идентификатор, время, состояние, источник, результат и иногда безопасные детали ошибки. Без событий команда видит, что проблема есть, но не может быстро помочь конкретному клиенту.
Я бы не противопоставлял эти вещи. Метрика замечает дым, а события помогают найти комнату. Полезный минимум — несколько метрик для каждой критичной цепочки и понятная история для каждой операции, которая в этой цепочке остановилась.
Не все ошибки одинаково срочные
Уведомление на каждую ошибку быстро превращается в шум. Через неделю его перестают читать, как слишком чувствительную сигнализацию у машины. Вместо этого стоит различать хотя бы три ситуации: операция не прошла и требует действия сейчас; операция задержалась, но система ещё может восстановиться; есть необычный сигнал, который нужно изучить, но он не блокирует работу.
Для каждой ситуации полезно заранее договориться, кто получает сигнал и что считается нормальным ответом. Не обязательно будить людей ночью из-за единичной временной ошибки. Но если критичная операция зависла дольше допустимого срока, «завтра посмотрим» уже не подходит.
Эта граница должна идти от бизнеса. В статье о допустимом простое для бизнеса я писал о той же логике: техническая цель без цены простоя остаётся красивой формулировкой. Сначала нужно понять, какую работу нельзя остановить и сколько времени она действительно может ждать.
Проверяйте наблюдаемость до аварии
Нельзя считать контур готовым только потому, что события начали записываться. Его нужно регулярно проверять. Самый простой способ — взять тестовую операцию и намеренно остановить её на безопасном шаге. Затем пройти путь глазами разных людей: оператора, руководителя процесса, разработчика поддержки. Видно ли, что произошло? Понятно ли, кто должен действовать? Есть ли в журнале данные, которых быть не должно?
Такая проверка часто обнаруживает не технические, а организационные дыры. Сигнал приходит в канал без владельца. Идентификатор есть в одном сервисе, но потерян при передаче. Уведомление говорит «ошибка 500», хотя на самом деле человеку достаточно проверить реквизиты. Или наоборот: экран выглядит спокойно, но повтор операции уже небезопасен.
Лучше провести короткую проверку раз в несколько недель, чем впервые открыть историю в момент, когда на кону деньги и репутация. Это похоже на проверку запасного выхода: он нужен не для красивой таблички на стене, а чтобы в нужный момент дверь действительно открылась.
Соблюдайте границу между полезными данными и лишними данными
У наблюдаемости есть обратная сторона. Желание сохранить всё может привести к тому, что в журналах оказываются персональные данные, реквизиты, токены или полные документы. Это создаёт новый риск и усложняет доступы. Для расследования почти всегда достаточно технического идентификатора, статуса, времени, типа ошибки и безопасной ссылки на объект внутри системы.
До запуска полезно договориться, кто видит журнал, как долго он хранится и какие поля нужно маскировать. Наблюдаемость должна помогать объяснять работу системы, а не становиться ещё одним неуправляемым хранилищем.
История решений важнее идеального расследования
Когда операция пошла не так, важно сохранить не только технический след, но и человеческое решение. Кто подтвердил повторную отправку, почему отменили заказ, кто принял риск, когда клиент получил ответ. Через неделю это помогает закрыть вопрос. Через квартал — увидеть слабое место процесса.
Такой журнал не должен быть романом. Достаточно даты, владельца, выбранного действия и короткой причины. Но без него система не учится: похожая проблема снова приходит как неожиданность, хотя уже случалась и уже решалась.
Как сделать первый полезный контур
Я бы начал с одной операции, которая связывает деньги, обязательство перед клиентом или внутренний дедлайн. Нарисуйте её путь на одной странице. Выберите идентификатор. Включите запись ключевых состояний. Настройте понятное оповещение на остановку дольше согласованного времени. Проверьте маршрут на тестовой ошибке: сможет ли человек, не участвовавший в разработке, понять, что произошло и что делать.
После этого полезно посмотреть на первые реальные события. Чего не хватает для ответа? Какие поля только шумят? Где журнал раскрывает секреты, которые не нужны для решения? Наблюдаемость — не витрина, которую однажды собрали. Это аккуратный язык, на котором система объясняет своё состояние людям.
О чём стоит договориться заранее
- Какие операции считаются критичными для бизнеса.
- Какой идентификатор проходит по их пути.
- Какие состояния и результаты фиксируются.
- Как отличить безопасный повтор от риска создать дубль.
- Кто видит сигнал и кто принимает решение.
- Как долго хранятся записи и какие данные в них нельзя сохранять.
Мой ориентир простой: если клиент спрашивает про конкретный заказ, команда должна за минуты, а не за часы понять его путь и следующий шаг. Когда это получается, система становится не только надёжнее. Ею становится легче управлять — до того, как проблема успела стать заметной всем.
Обсудим?