Я начинаю разбор сбоя с последнего корректного шага, а не с первой ошибки
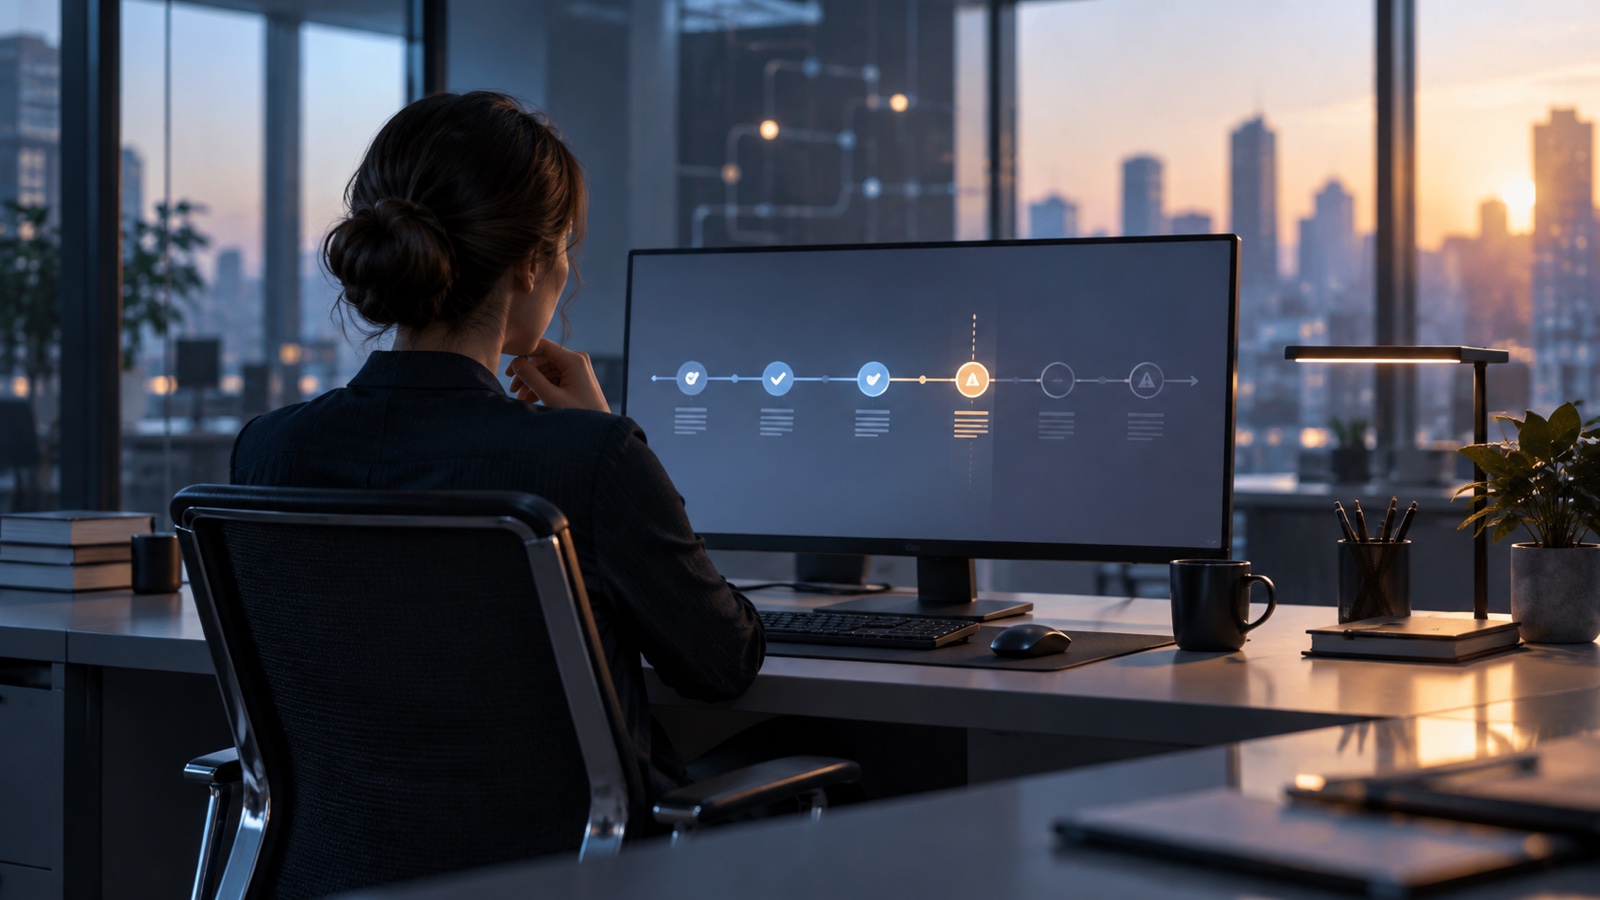
Когда бизнес-система даёт сбой, разговор часто начинается с первой заметной ошибки: письмо не ушло, заказ не появился, менеджер увидел пустой статус. Я начинаю в другом месте — с последнего шага, о котором мы точно знаем, что он прошёл правильно.
Это не игра в слова. Первая ошибка бывает следствием, а не причиной. А последний корректный шаг быстро сужает поиск: значит, всё, что было раньше, пока не надо трогать. Можно спокойно проверить переход между двумя точками вместо того, чтобы одновременно перезапускать сервисы, писать в три чата и искать виноватого.
Ошибка видна позже, чем начинается проблема
Представим обычный путь заказа. Покупатель оформил его на сайте, CRM приняла заявку, учётная система зарезервировала товар, служба доставки получила задачу. В 11:20 менеджер видит, что доставки нет. Если начать с этого экрана, можно потратить час на службу доставки, хотя заявка не прошла проверку адреса ещё в CRM.
Я бы задал четыре коротких вопроса: какое действие пользователь совершил; какой результат он должен был получить; какой последний факт мы можем подтвердить; кому принадлежит следующий переход. Это уже не абстрактное «система не работает», а конкретная операция с границей.
Такой подход особенно полезен там, где данные переходят между несколькими системами. На стыке легко спорить о том, кто «должен был увидеть» запись. Но спор не помогает клиенту. Помогает последовательность: создано → проверено → принято → передано → выполнено. Для каждого состояния нужны время, идентификатор операции и понятный владелец.
Не путать наблюдение и догадку
В разборе инцидента полезно разделять три вещи. Первая — наблюдение: «заказ 8421 создан в 10:03». Вторая — вывод: «между CRM и учётом произошёл сбой». Третья — действие: «повторно отправляем запись». Когда всё смешано в одном сообщении, команда начинает лечить предположение как факт.
Я стараюсь сначала собрать маленькую карточку события. В ней достаточно номера операции, времени, исходной системы, ожидаемого и фактического статуса, ссылки на безопасный технический след и имени человека, который ведёт следующий шаг. Лишние скриншоты и длинная переписка не делают её лучше.
Важно не превращать такую карточку в склад персональных данных. Для диагностики обычно нужны технический идентификатор, тип события и статус, а не копия документа, телефона или реквизитов. О том, как строить видимость процесса без лишнего риска, я писал в статье о наблюдаемости до критического сбоя.
Последний правильный шаг — это опорная точка
Допустим, известно, что CRM приняла заказ, но учётная система его не видит. Дальше не надо проверять всё подряд. Нужны ответы на более узкие вопросы: сформировалось ли сообщение; попало ли оно в очередь; забрал ли его получатель; ответил ли он ошибкой; сохранился ли ответ там, где его можно связать с заказом.
Такая цепочка похожа на поиск пропавшего багажа. Если чемодан точно зарегистрировали в аэропорту вылета, бессмысленно разбирать шкаф дома. Надо смотреть следующий участок маршрута. Чем короче участок между «было хорошо» и «стало непонятно», тем быстрее можно восстановить работу и тем меньше риск сделать лишнее.
Это правило применимо не только к интеграциям. В SaaS оно помогает с незавершёнными действиями пользователя. В учётной системе — с документом, который застрял на согласовании. В поддержке — с обращением, которое исчезло между первой линией и разработкой. Даже у ручного процесса есть последний надёжно выполненный шаг.
Какие следы нужны, чтобы не гадать
У каждой критичной операции я бы оставил минимум следов. Это не обязательно дорогая платформа мониторинга. Важно, чтобы по одному идентификатору можно было увидеть создание, смену состояния, передачу во внешнюю систему и финальный результат. Время стоит хранить в одном понятном формате, а статус — называть так, чтобы его не приходилось расшифровывать разработчику по исходному коду.
Полезно различать событие и снимок. Снимок говорит, что сейчас заказ находится в статусе «ожидает проверки». Событие объясняет, как он туда попал: кто изменил состояние, когда и с каким основанием. Одного снимка хватает для работы сегодня, но при сбое без событий команда вынуждена восстанавливать прошлое по памяти. А память особенно ненадёжна в напряжённый день.
След не должен быть шумом. Записывать каждое открытие экрана бессмысленно, если это не влияет на риск. Гораздо полезнее увидеть изменение ответственного, отказ проверки, постановку в очередь, попытку повторной отправки и окончательное подтверждение. Тогда журнал помогает принять следующее решение, а не становится ещё одним местом, где ничего нельзя найти.
Как говорить с бизнесом во время инцидента
Техническая команда часто знает больше деталей, чем нужно руководителю или клиенту. Но короткое сообщение должно давать не меньше ясности: что именно затронуто, с какого времени, какой обход сейчас безопасен, кто ведёт восстановление и когда будет следующий статус. Формула «разбираемся» честная, но бесполезная, если она не привязана к операции и времени.
Я бы избегал обещаний до проверки. Лучше сказать: «заказы, созданные после 10:03, пока не передаются в учёт; предыдущие операции подтверждены; повторно не отправляйте; следующую проверку дадим в 10:30». Это снимает лишние действия людей и оставляет пространство для честного разбора причины.
Граница должна быть видна заранее
Самый дорогой инцидент — тот, в котором впервые выясняется, что две команды по-разному понимали ответственность. Одна считает, что передала данные, другая — что получила только техническое сообщение, а бизнес уверен, что услуга уже оказана. Поэтому ожидаемый результат перехода стоит согласовать до сбоя: что считается принятым, когда операция считается окончательной, кто видит отказ и кто связывается с клиентом.
Для такого соглашения не нужен сложный регламент. Иногда хватает нескольких строк рядом с описанием процесса. Но они должны переживать смену людей и релизы. Тогда последний корректный шаг остаётся фактом системы, а не воспоминанием одного специалиста.
Почему повторить действие — не всегда исправить проблему
Когда работа стоит, самый соблазнительный ход — нажать «отправить ещё раз». Иногда это правильно. Иногда так появляются два платежа, две отгрузки или две одинаковые задачи. Поэтому перед повтором я бы проверил две вещи: можно ли безопасно отличить новую попытку от уже выполненной и что произойдёт, если первая попытка всё-таки дошла.
В хорошем процессе повтор не выглядит как импровизация. У операции есть идентификатор, система умеет сказать «это уже обрабатывалось», а человеку понятно, где посмотреть результат. Если этого нет, повторная отправка — не лечение, а ставка на удачу.
Тот же принцип полезен при изменении правил. Нельзя объяснить сбой фразой «вчера что-то переключили», если нет истории: что изменили, почему, кто подтвердил и как вернуть старое поведение. Живая документация нужна именно для следующего изменения, а не для красивой папки: я разбирал этот подход отдельно.
Что стоит сделать после восстановления
После того как операция снова пошла, легко закрыть чат и переключиться на следующую срочность. Но именно в этот момент есть шанс сделать систему спокойнее. Я обычно оставляю короткую запись: где обнаружили проблему, какой был последний корректный шаг, как восстановили работу, чего не хватило для быстрой проверки и кто владеет улучшением.
Не каждый инцидент требует большой переработки. Иногда достаточно добавить статус в очередь, сохранить ответ внешнего сервиса или назвать настройку человеческим языком. Иногда выясняется, что проблема организационная: никто не отвечал за переход между отделами. Но это можно увидеть только после того, как отделили факт от предположения.
Короткий чек-лист для следующего сбоя
- Назовите одну конкретную операцию, а не «всю систему».
- Зафиксируйте последний подтверждённо корректный шаг и время.
- Проверьте один переход после него, а не все сервисы сразу.
- Разделите факт, гипотезу и действие в сообщении команде.
- Не повторяйте операцию, пока не понятен риск дубля.
- После восстановления оставьте след, который сократит следующий разбор.
Надёжность не означает, что ошибок никогда не будет. Она означает, что команда умеет быстро и безопасно понять, где остановилась работа. Последний правильный шаг — простая опорная точка, которая возвращает разговор от паники к управляемому действию.
Обсудим?